

React是web前端框架
## React是web前端框架 1. 目前市面上比较主流的前端框架 1. React 2. Vue 3. Angular "NG" 主流思想:不在直接取操作DOM,而是改为“数据驱动思想” 操作DOM思想 > - 操作DOM比较消耗性能“主要原因是:可能导致DOM重排(回流)/重绘” > - 操作起来相对来讲麻烦一些 数据驱动思想 > - 我们不会直接操作DOM > - 我们去操作数据“当我们修改了数据,框架会按照相关的数据,让页面重新渲染” > - 框架底层实现的视图的渲染,也是基于操作DOM完成的 > - 构建了一套虚拟DOM->真实DOM的渲染体系 > - 有效避免了DOM的重排/重绘 > - 开发效率更高、最后的性能也相对较好 2. React框架采用的是MVC体系;Vue框架采用的是MVVM体系; > MVC: M是model,是数据层,V是View视图层 + C是controller是控制层 > > - 我们需要安照专业的语法去构建视图(页面):React中基于jsx语法来构建
linux挂载共享目录脚本
### 实现windows下共享的目录挂载到linux目录 - 用途 windows下编写的代码在linux下测试运行 - 实现脚本如下: ```bash #!/bin/bash # 共享目录 src="//192.168.1.77/game" # 挂载目录 dest="/home/zcm/share/game" cmd="mount -t cifs -o rw,username=admin,password=1111,uid=1000,gid=1000,iocharset=cp936,file_mode=0777,dir_mode=0777 $src $dest" if [ `df | grep share | wc -l` -eq 0 ]; then echo "not mounted" echo $cmd $cmd else echo "mounted" echo umount $dest umount $dest fi ```
设计模式的六大原则
##设计模式 ### 设计模式的六大原则 #### 原则一:单一职责原则 定义:一个类只负责一项职责。 讨论:主要疑难点就是如何控制住职责扩散 (所谓职责扩散,就是,就是因为某种原因,职责P被分化为粒度更细的职责P1和P2。)? 遵循单一职责原的优点有: 1. 可以降低类的复杂度,一个类只负责一项职责,其逻辑肯定要比负责多项职责简单的多; 提高类的可读性,提高系统的可维护性; 2. 变更引起的风险降低,变更是必然的,如果单一职责原则遵守的好,当修改一个功能时,可以显著降低对其他功能的影响。 (需要说明的一点是单一职责原则不只是面向对象编程思想所特有的,只要是模块化的程序设计,都适用单一职责原则)。 #### 原则二:里氏替换原则 定义1:如果对每一个类型为 T1的对象 o1,都有类型为 T2 的对象o2,使得以 T1定义的所有程序 P 在所有的对象 o1 都代换成 o2 时,程序 P 的行为没有发生变化,那么类型 T2 是类型 T1 的子类型。 定义2:所有引用基类的地方必须能透明地使用其子类的对象 讨论:有一功能P1,由类A
斐波那契数
# 斐波那契数 **斐波那契数** (通常用 `F(n)` 表示)形成的序列称为 **斐波那契数列** 。该数列由 `0` 和 `1` 开始,后面的每一项数字都是前面两项数字的和。也就是: ``` F(0) = 0,F(1) = 1 F(n) = F(n - 1) + F(n - 2),其中 n > 1 ``` 给定 `n` ,请计算 `F(n)` 。 **示例 1:** **输入:**n = 2 **输出:**1 **解释:**F(2) = F(1) + F(0) = 1 + 0 = 1 **示例 2:** **输入:**n = 3 **输出:**2 **解释:**F(3) = F(2) + F(1) = 1 + 1 = 2 **示例 3:** **输入:**n = 4 **输出:**3 **解释:**F(4) = F(3) + F(2) = 2 + 1 = 3 **提示:** * `0 <= n <= 30` 以下是 JavaScript 代码实现: ```js /** * @
nodejs最新版本安装相关依赖问题
近期经常遇到使用源码编译的部署方式进行应用部署,在 GCC 编译环境上遇到各种问题,本文对升级部署 GCC 编译环境的流程以及遇到的一些问题进行记录。 一、python3 gcc 11.2 安装需要 python3 yum install -y python3-devel 二、升级 Make # 查看版本 make -v ```bash # 查看版本 make -v # 下载 wget http://ftp.gnu.org/pub/gnu/make/make-4.3.tar.gz # 解压 tar -zxvf make-4.3.tar.gz cd make-4.3 # 编译 ./configure --prefix=/usr/local/make make make install # 应用 # 找一下都有哪些 make whereis make cd /usr/bin/ # 把默认的 make 改名 mv make make.bak # 建立一个软连接 ln -sv /usr/loca
【NodeJS】GLIBC_2.28 not found CentOS7不兼容Node高版本
提前部署 1. 安装编译环境devtoolset-8 2. 编译安装glibc-2.28 3. 编译安装gcc高版本并配置LD_LIBRARY_PATH 参考链接: https://github.com/nodejs/build/issues/2815 https://cloud.tencent.com/developer/article/2021784 操作步骤 1、安装编译环境devtoolset-8 `sudo yum install centos-release-scl ` `sudo yum install devtoolset-8` `scl enable devtoolset-8 bash` `gcc --version` 2、编译安装glibc-2.28 ``` wget https://ftp.gnu.org/gnu/glibc/glibc-2.28.tar.gz --no-check-certificate tar -xzvf glibc-2.28.tar.gz cd glib
使用yum时出现Error: rpmdb open failed解决方案
一、问题描述 使用yum安装软件时出现Error: rpmdb open failed,报错信息显示rpm数据库被损坏。 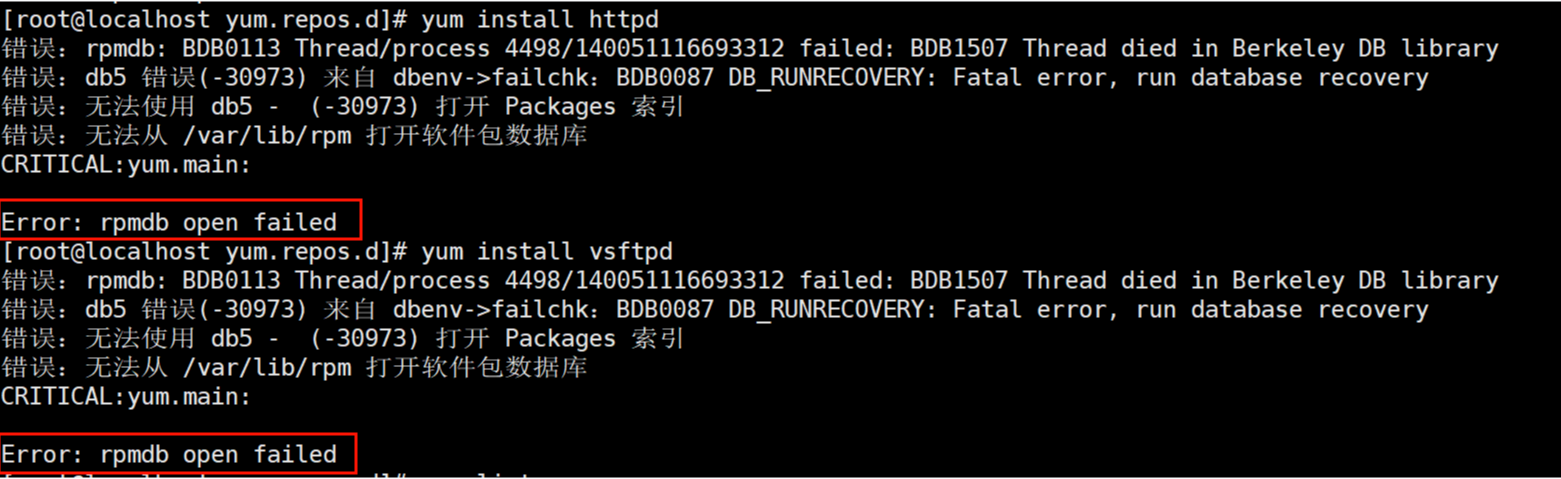 二、解决方案 - 重建rpm数据库。 ```bash [root@localhost yum.repos.d]# cd /var/lib/rpm [root@localhost rpm]# ls Basenames __db.001 __db.003 Group Name Packages Requirename Sigmd5 Conflictname __db.002 Dirnames Installtid Obsoletename Providename Sha1header Triggername [root@localhost rpm]# rm __db.* -rf [root@localhost rpm]# ls Basenames Dirnames Installti
JavaScript之封装
## 封装 ### es5封装 ```js function Person(name, sex, age) { if (!(this instanceof Person)) { return new Person(name, sex, age); } this.name = name; this.sex = sex || 'female'; this.age = age || 0; this.walk = function() { if (this.age <= 2) { return console.log('我不会走路'); } if (this.age >2 && this.age < 4) { return console.log('我会走路了'); } return console.log('走路'); } thi
JavaScript之Map
## Map ### 语法 ```js new Map([iterable]) ``` ### 参数 `iterable` Iterable 可以是一个数组或者其他 iterable 对象,其元素或为键值对,或为两个元素的数组。 每个键值对都会添加到新的 Map。null 会被当做 undefined。 ## 描述 一个Map对象以插入顺序迭代其元素 — 一个 for...of 循环为每次迭代返回一个[key,value]数组。 ### 键的相等(Key equality) 键的比较是基于 "SameValueZero" 算法:`NaN` 是与 `NaN` 相同的(虽然 `NaN` !== `NaN`),剩下所有其它的值是根据 === 运算符的结果判断是否相等。在目前的ECMAScript规范中,`-0`和`+0`被认为是相等的,尽管这在早期的草案中并不是这样。有关详细信息,请参阅浏览器兼容性 表中的“value equality for -0 and 0”。 ### Objects 和 maps 的比较 `Object` 和 `Ma
RestTemplate文件上传下载
### 使用RestTemplate下载文件 ```java String url = "需要下载的文件地址"; HttpHeaders header = new HttpHeaders(); List<MediaType> list = new ArrayList<MediaType>(); // 指定下载文件类型 list.add(MediaType.APPLICATION_OCTET_STREAM); header.setAccept(list); HttpEntity<byte[]> request = new HttpEntity<byte[]>(params, header); ResponseEntity<byte[]> response = this.restTemplate.exchange(url, HttpMethod.POST, request, byte[].class); // 取得文件字节 byte[] result = response.getBody(); ``` ### 使用RestTemplate上传文件 ```ja
Scrapy: 高效的Python网络爬虫框架
# Scrapy: 高效的Python网络爬虫框架 在当今数据驱动的世界中,网络爬虫是获取数据的关键工具之一。**Scrapy** 是一个开源的Python库,专门用于构建高效和可扩展的网络爬虫。它提供了丰富的功能来抓取和处理网站的数据,是开发者和数据科学家喜爱的工具之一。 ## Scrapy简介 Scrapy是一个强大而灵活的爬虫框架,设计用于抓取网站并提取结构化数据。它最初是为网页爬取而设计的,但也可以用于提取API数据或者其他类型的数据。 ### 主要特点 1. **速度和效率**:Scrapy基于Twisted异步网络框架,能够高效处理多个请求。 2. **易于使用**:提供了强大的选择器和解析机制,帮助用户快速提取数据。 3. **可扩展性**:支持多种中间件和插件,便于自定义和扩展。 4. **维护性**:通过项目的结构化管理,使得代码可读性高,易于维护。 ## Scrapy的基本使用 Scrapy提供了一个命令行工具,可以帮助我们快速创建爬虫项目,并生成基础结构。以下是使用Scrapy进行基本爬虫开发的步骤。 ###
爬楼梯
# 爬楼梯 假设你正在爬楼梯。需要 `n` 阶你才能到达楼顶。 每次你可以爬 `1` 或 `2` 个台阶。你有多少种不同的方法可以爬到楼顶呢? 示例1 > ``` > 输入:n = 2 > 输出:2 > 解释:有两种方法可以爬到楼顶。 > 1. 1 阶 + 1 阶 > 2. 2 阶 > ``` 实例2 > ``` > 输入:n = 3 > 输出:3 > 解释:有三种方法可以爬到楼顶。 > 1. 1 阶 + 1 阶 + 1 阶 > 2. 1 阶 + 2 阶 > 3. 2 阶 + 1 阶 > ``` 提示 > `1 <= n <= 45` 这是一个经典的动态规划问题,可以使用递推或动态规划的方法解决。 假设到达第 n 阶楼顶的方法只有两种:从第 n-1 阶跨一步到达,或者从第 n-2 阶跨两步到达。那么到达第 n 阶楼顶的方法总数就是到达第 n-1 阶楼顶的方法数和到达第 n-2 阶楼顶的方法数之和。 我们可以使用一个数组 dp 来保存到达每一阶楼顶的方法总数。数组初始化为 dp[0]=1 和 dp